Việt Điển: Từ các Bộ sưu tập Hán–Nôm Số hóa đến Kho ngữ liệu Phục vụ Nghiên cứu
Số hóa giúp các tư liệu lịch sử trở nên dễ tiếp cận hơn. Nhưng tiếp cận mới chỉ là bước khởi đầu.
Đối với các nhà nghiên cứu làm việc với tư liệu Hán–Nôm, một bản thảo hay sách in đã được số hóa đôi khi vẫn đòi hỏi một quy trình cơ bản tương tự như khi làm việc với bản vật lý: tìm văn bản, mở từng trang, đọc và lần lượt xác định những chữ, cụm từ, tên riêng hay đoạn văn có liên quan. Vậy điều gì sẽ trở nên khả thi nếu hàng trăm văn bản số hóa có thể được tìm kiếm đồng thời như một kho ngữ liệu?
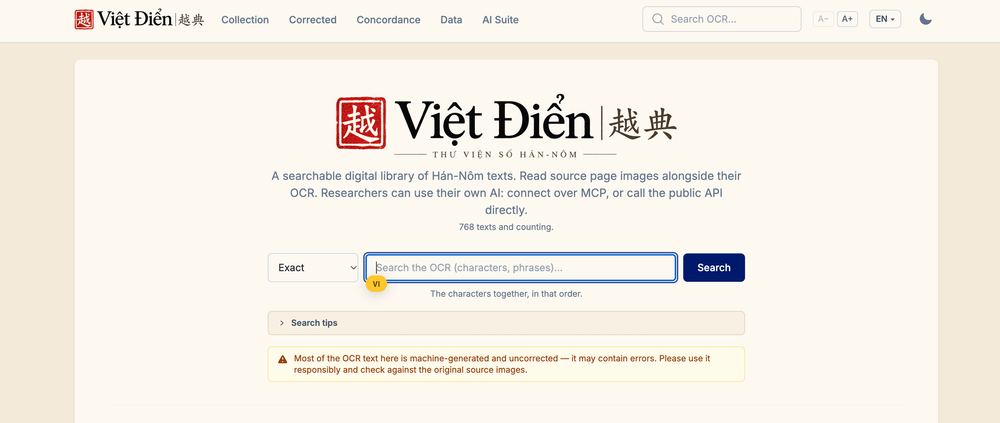
Việt Điển (越典), hiện đã được tích hợp vào Không gian Nghiên cứu Hán–Nôm (Hán–Nôm Research Hub) trên nền tảng Digitizing Vietnam, chính là một thử nghiệm nhằm khai mở khả năng này.
Được phát triển bởi Albert Errickson, một thành viên của nhóm Digitizing Việt Nam, Việt Điển là một thư viện số có chức năng tìm kiếm, được thiết kế chuyên biệt để làm việc với văn bản Hán–Nôm. Nền tảng kết nối hình ảnh các trang tài liệu đã số hóa với văn bản ở định dạng máy có thể đọc được, cho phép nhà nghiên cứu di chuyển qua lại giữa tài liệu lịch sử và bản văn được nhận dạng bằng OCR, thay vì xem chúng như hai nguồn tư liệu tách biệt. Kho ngữ liệu đang tiếp tục được mở rộng, hiện bao gồm hàng trăm văn bản với hàng chục nghìn trang tài liệu số hóa, trong đó một phần đáng kể đến từ các nguồn tư liệu được cung cấp bởi Digitizing Vietnam, Thư viện Đại học Columbia, Vietnamese Nôm Preservation Foundation cùng nhiều kho lưu trữ số khác.
Từ thư viện số đến kho ngữ liệu nghiên cứu
Ý nghĩa của Việt Điển không chỉ nằm ở việc đưa thêm nhiều sách cổ lên môi trường trực tuyến, mà còn ở việc thay đổi cách chúng ta có thể khám phá và nghiên cứu những tài liệu này.
Chẳng hạn, một nhà nghiên cứu quan tâm đến khái niệm 國家 (quốc gia, nhà nước) không còn nhất thiết phải biết trước tác phẩm cụ thể nào có khả năng chứa thuật ngữ này. Việt Điển có thể tìm kiếm kết quả OCR trên toàn bộ kho ngữ liệu và xác định những trang có xuất hiện các chữ cần tìm. Hệ thống tìm kiếm cũng hỗ trợ những truy vấn phức tạp hơn: người dùng có thể tìm nhiều thuật ngữ xuất hiện trên cùng một trang, tìm các phương án thay thế, loại trừ một số kết quả, tìm theo mẫu ký tự hoặc tìm các từ xuất hiện trong một khoảng cách nhất định với nhau. Hệ thống cũng tự động tính đến sự khác biệt giữa các dạng chữ giản thể và phồn thể.
Nhờ đó, nghiên cứu có thể bắt đầu không chỉ từ một cuốn sách, tác giả hay nhan đề cụ thể, mà còn từ một chữ, cụm từ, tên riêng, khái niệm hoặc mô thức văn bản.
Chức năng Concordance (tra cứu ngữ cảnh) của nền tảng mở rộng cách tiếp cận này thêm một bước. Thay vì chỉ xác định những trang có chứa một thuật ngữ, công cụ đặt mỗi lần xuất hiện của thuật ngữ đó bên cạnh phần văn bản xung quanh. Khi đọc các trường hợp này cùng nhau, nhà nghiên cứu có thể nhận diện những cách diễn đạt lặp lại, các từ thường xuất hiện cùng nhau, sự thay đổi trong cách sử dụng từ ngữ, cũng như những mô thức khó nhận ra nếu chỉ đọc riêng lẻ từng văn bản.
Đối với nghiên cứu Hán–Nôm, điều này mở ra nhiều khả năng nghiên cứu liên văn bản: lần theo sự xuất hiện và biến đổi của thuật ngữ trong các tác phẩm lịch sử; so sánh cách một khái niệm được sử dụng trong những thể loại khác nhau; khảo sát các cấu trúc diễn đạt lặp lại; hoặc xác định những tư liệu đáng được tiếp tục khảo cứu sâu hơn về mặt văn bản học và ngữ văn học.
Giữ nguyên bản tài liệu ở vị trí trung tâm
Đồng thời, Việt Điển không xem OCR là sự thay thế cho tài liệu lịch sử gốc.
Các kết quả tìm kiếm dẫn người dùng trở lại từng trang tài liệu cụ thể, nơi hình ảnh của nguyên bản có thể được đọc song song với văn bản do máy nhận dạng. Mối liên hệ này đặc biệt quan trọng đối với tư liệu Hán–Nôm, bởi các dạng chữ cổ, kỹ thuật in mộc bản, dị bản giữa các bản thảo, tình trạng vật lý của trang sách và sự phức tạp của chữ Nôm đều có thể đặt ra những thách thức đối với công nghệ nhận dạng tự động.
Vì vậy, Việt Điển phân biệt rõ giữa văn bản OCR do máy tạo ra và những văn bản đã được con người kiểm tra thủ công. Bộ sưu tập Corrected Texts (Văn bản đã hiệu đính) tập hợp những bản phiên văn đã được đối chiếu từng chữ với hình ảnh quét của nguyên bản. Đối với kho ngữ liệu lớn hơn được tạo bằng phương pháp nhận dạng tự động, nền tảng lưu ý rằng kết quả OCR có thể chứa sai sót và khuyến khích người dùng luôn kiểm chứng kết quả với hình ảnh tài liệu gốc.
Nguyên tắc này cũng là một phần quan trọng trong cách tiếp cận của Không gian Nghiên cứu Hán–Nôm: các công cụ tính toán có thể giúp nhà nghiên cứu phát hiện mô thức và khám phá các bộ sưu tập ở quy mô mà phương pháp truyền thống khó thực hiện, nhưng việc diễn giải học thuật vẫn cần quay trở lại với nguồn tư liệu, xem xét ngữ cảnh văn bản và đánh giá chứng cứ một cách thận trọng.
Kết nối nguồn tư liệu Hán–Nôm với nghiên cứu hỗ trợ bởi AI
Việt Điển cũng mở ra một thử nghiệm về cách các bộ sưu tập lịch sử có thể tương tác với một thế hệ công cụ nghiên cứu mới được hỗ trợ bởi trí tuệ nhân tạo (AI).
Thông qua API công khai và giao diện Model Context Protocol (MCP), nhà nghiên cứu có thể kết nối các trợ lý AI tương thích với kho ngữ liệu Việt Điển. AI sau đó có thể tìm kiếm trong bộ sưu tập, xác định những lần xuất hiện của một thuật ngữ, so sánh sự phân bố của thuật ngữ đó giữa các văn bản, truy xuất kết quả OCR từ những trang cụ thể và dẫn người nghiên cứu trở lại hình ảnh của nguồn tư liệu tương ứng.
Chẳng hạn, một nhà nghiên cứu có thể đặt câu hỏi:
Những văn bản nào đề cập đến 科舉 (khoa cử), tức hệ thống thi tuyển quan lại?
Hoặc:
皇越 xuất hiện ở đâu trong kho ngữ liệu và được sử dụng trong những ngữ cảnh nào?
Thay vì phải biết chính xác những chữ cần tìm ngay từ đầu, nhà nghiên cứu cũng có thể bắt đầu bằng một câu hỏi được diễn đạt bằng ngôn ngữ thông thường, sau đó sử dụng kho ngữ liệu để xác định những văn bản và đoạn văn có liên quan nhằm tiếp tục khảo sát sâu hơn.
Điểm quan trọng ở đây không phải là để AI thay thế việc đọc hay diễn giải văn bản. Thay vào đó, kho ngữ liệu cung cấp cho AI một con đường có cấu trúc để quay trở lại với chứng cứ lịch sử. Việt Điển hướng dẫn người dùng kiểm chứng các kết quả có sự hỗ trợ của AI với hình ảnh trang tài liệu và trích dẫn nguồn tư liệu gốc thay vì trích dẫn chính trợ lý AI. Nền tảng cũng lưu ý rằng việc tìm kiếm OCR không trả về kết quả không đồng nghĩa với việc có thể kết luận một nội dung nào đó không tồn tại trong tư liệu lịch sử: một chữ có thể đã bị nhận dạng sai, hoặc một tác phẩm có liên quan có thể chưa được số hóa.
Trong mô hình này, AI trở thành một giao diện hỗ trợ khám phá và định hướng, trong khi tài liệu lịch sử gốc vẫn là nền tảng của chứng cứ.
Xây dựng một môi trường nghiên cứu Hán–Nôm kết nối
Việc tích hợp Việt Điển vào Không gian Nghiên cứu Hán–Nôm là một phần trong nỗ lực rộng hơn của Digitizing Vietnam nhằm xây dựng một môi trường số kết nối phục vụ nghiên cứu di sản văn bản Việt Nam thời tiền hiện đại.
Không gian này tập hợp các kho lưu trữ số và danh mục bản thảo cùng những công cụ phục vụ OCR, tra cứu đồng thời nhiều từ điển, tìm kiếm kho ngữ liệu, chuyển đổi niên đại, các nguồn tài liệu tham khảo và nền tảng học chữ Nôm. Thay vì để nhà nghiên cứu và người học phải tiếp cận các bộ sưu tập số hóa, từ điển, công cụ phiên chuyển và phương pháp tính toán như những nguồn lực riêng lẻ, Không gian Nghiên cứu Hán–Nôm hướng tới việc kết nối chúng trong một quy trình nghiên cứu chung.
Việt Điển bổ sung một lớp quan trọng cho hệ sinh thái này: khả năng khám phá ở cấp độ kho ngữ liệu.
Một trang tài liệu số hóa có thể được đọc. Một bản OCR có thể được tìm kiếm. Một kho ngữ liệu cho phép hàng trăm văn bản được khảo sát trong mối quan hệ với nhau.
Sự khác biệt này hướng đến một tham vọng rộng hơn của Digitizing Vietnam. Bảo tồn di sản văn hóa bằng công nghệ số không nên dừng lại ở việc tạo ra một điểm đến tĩnh, nơi các tài liệu lịch sử đơn thuần được lưu trữ trực tuyến. Các bộ sưu tập số có thể trở thành nền tảng cho những câu hỏi mới, phương pháp mới và những hình thức hợp tác mới, đồng thời vẫn duy trì những con đường rõ ràng để người nghiên cứu quay trở lại với tư liệu gốc – nền tảng của nghiên cứu học thuật.
Việt Điển cho thấy một cách mà quá trình chuyển đổi ấy có thể diễn ra: từ trang tài liệu đến văn bản, từ văn bản đến kho ngữ liệu, và từ kho ngữ liệu trở lại với nguồn tư liệu lịch sử.
Khám phá Việt Điển trong Không gian Nghiên cứu Hán–Nôm trên nền tảng Digitizing Vietnam: